随着军事信息化和智能化的深入,作战条例、情报简报和战史资料这些海量的非结构化文本,已经成为军事决策非常重要的信息来源。但在实际操作中发现,传统文本处理方法在面对军事文本时往往显得力不从心。这些文本不仅专业术语极其密集、格式五花八门,而且保密要求极高。因此,本文把目光投向了大模型在军事文本智能挖掘中的应用。尝试通过大模型微调优化、军事领域预训练、文本语义对齐以及知识图谱融合等技术手段,去实现军事文本的精准提取、意图识别和知识复用,最终搭起一套从文本输入、智能挖掘、知识输出到决策适配的完整技术流程。
不可否认,现在军事领域的非结构化文本数据正呈爆发式增长。但由于军事文本高度专业、对抗性强且高度保密,传统的文本处理技术确实遇到了瓶颈。特别是在指挥决策这种争分夺秒的场景下,怎么从海量且杂乱无章的文本里快速揪出关键信息、看透敌方战术意图、把历史经验用起来,成为军事智能化发展亟待突破的核心瓶颈。美军在这块已经走在了前面,比如他们的NIPRGPT系统在整理非机密情报时,速度比人工快了两百倍,准确率还能保持在92%;而ClaudeAI大模型在九十分钟内处理了2.3PB的异构数据,效率比人工高了将近八百倍。这些案例让人看到了大模型在军事文本智能挖掘上的巨大潜力。
但也得承认,现在大模型在军事里的应用还有不少短板。比如,缺乏专门针对军事文本特征的微调策略,军事领域预训练语料库建设没跟上,文本的语义对齐和知识图谱融合技术还不够成熟等。尤其是在解读作战条例、识别情报意图和复用战史经验时,怎么保证大模型给出的结果可靠且能解释得通,是目前亟待解决的难题。所以,本文就是要解决这些痛点,通过提出增强领域知识的大模型微调方法、构建覆盖七十多个军事场景的专业语料库、设计专门的语义对齐和知识图谱融合技术,来为指挥决策提供一套高效、可靠的知识支撑体系。
军事非结构化文本的特征分析与技术挑战
军事文本的类型和结构有它自己的一套规律。像作战条例,它是作战训练的根本依据,必须权威、指导性强,所以它的语言要求通俗易懂,专业术语界定必须统一,段落逻辑要严密。情报简报就完全不同了,它往往表现得非常非结构化,信息组织松散,格式自由。而且因为时间紧、人员水平参差不齐或者传输带宽受限,这些简报经常存在长度短、指代不清、术语不准等问题,识别难度极大。至于战史资料和演习文书,那就更复杂了。战例研究是对战争的复盘,需要从庞杂的记录中去粗取精,找出交战双方在指挥、力量运用和后勤保障上的关键点。演习文书更是包含了时间、地区、行动、控制等实体特征,数据格式极不统一,给训练评估带来了巨大压力。
处理这些文本,面临着几个非常棘手的挑战。首先是数据稀缺,军事数据太敏感,能拿来做标注的语料极少,这严重制约了深度学习算法的性能表现。其次是数据极其复杂,涵盖了海陆空天电网等多个维度,一句话里可能就塞满了武器装备型号、地点、任务等多种实体和属性关系,建模非常困难。再者是强对抗性,战场上的数据往往真假难辨、充满不确定性,这比处理民用大数据难得多。另外,格式不统一、专业术语密集以及由于环境恶劣导致的文档质量下降(比如手写体模糊、缩微胶片颗粒感重等),都让传统的文本处理方法频频碰壁。
传统方法在军事领域的局限性显而易见。比如在文本分块上,传统策略经常把军事实体生生截断,导致在向量空间里发生语义漂移。在命名实体识别和战术要素识别上,面对复杂的战术动作句式,传统解析方式很难精准抓取关键作战要素。构建问答系统时,传统的流水线方法又容易产生误差传递,导致整体性能不稳定。更头疼的是,军事决策需要战略层面的“猜”和战术层面的“证”相互配合,而现有的大模型很难把这两种逻辑清晰地解耦。
大模型技术路径与方法设计
为了让大模型适应军事文本,提出一套基于“通用语言理解能力保持”与“军事领域任务性能”双目标优化的微调策略。简单来说,就是既要保住大模型原有的通用语言能力,又要让它学会军事领域的专门知识。
在预训练语料库的构建上,力求全面,覆盖内部术语库、法规条例、演习报告、作战文书等多类语料来源。先在大规模无标注军事语料上跑预训练,让它吸足军事知识,然后再进行微调。为了让模型能分清不同类型的文本,在训练时给不同语料分配了特定的标识符。
解决军事文本语义歧义的关键在于文本语义对齐技术。在实体对齐时融合了实体名称、类别、属性等多种特征。针对词汇在不同语境下的多重含义,引入了预训练语言模型和注意力机制,结合上下文甚至句法结构来推断最准确的语义。
要把这些非结构化文本变成机器能懂的语言,知识图谱融合是必由之路。这个思路是用向量库搞定语义检索,用知识图谱解决逻辑推理。具体操作上,利用大语言模型从文本里提取出关键实体和它们之间的关系,变成结构化的三元组,然后再把这些数据倒进图数据库里,织成一张清晰的知识网。
在这套体系里,各种主流大模型都找到了自己的用武之地。GPT系列在情报处理和文本生成上表现抢眼,处理速度和准确率双高;Claude 系列在多模态异构数据的批量解析与跨语言翻译上具备显著效率优势;BERT系列在军事问答和实体识别上性能稳定。
军事文本智能挖掘的应用场景与验证指标
在作战条例解读场景中,系统必须像个老参谋一样,不仅要抠字眼,还得懂实战。它要能准确识别专业术语,理清条款间的逻辑,甚至要能根据不同的作战阶段推断出条例的具体应用方式。这就要求系统具备极强的跨条令关联检索和场景适配推理能力。
情报提炼则像是在沙里淘金。系统的首要任务是把IP地址、攻击组织这些威胁要素抽出来。根据业内公认的标准,威胁情报包含攻击者、攻击手段、影响面等十七个核心指标。情报分析流程分为三步:先从流量和日志里揪出恶意行为生成威胁信息,接着用数据挖掘算法给攻击者画像生成威胁知识,最后用预测模型研判攻击趋势,给出防御策略,最终形成真正的威胁情报。
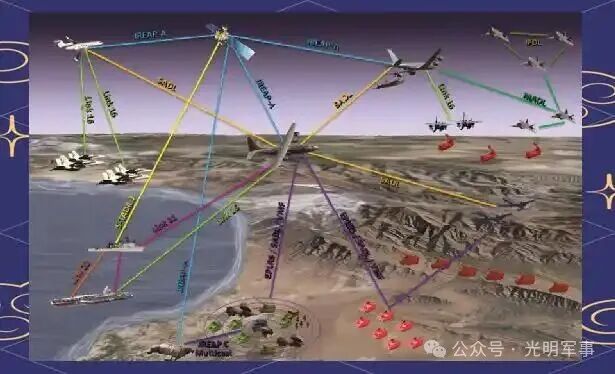
战史复盘考验的是系统“讲故事”和“找规律”的能力。系统得从庞杂的战例中提炼出交战双方的力量运用逻辑与指挥决策规律。比如复盘黄土岭战斗,系统得能提取出“情报与地形是战力倍增器”“精准打击关键节点”这些历久弥新的制胜法则,把它们转化成未来能用的经验知识。除了精确率、召回率等通用指标外,更看重一些军事专用指标。比如军事概念识别准确率,它必须考虑到军事术语中大量的缩写和代号;还有战术意图理解准确率等。此外,跨语言处理能力、毫秒级的实时处理性能以及在强电磁干扰下的系统鲁棒性,都是评估大模型是否真的具备实战价值的核心硬指标。
从文本到决策的完整技术流程构建
整个技术流程的第一步是文本输入与预处理。军事文档格式有很多,得先把PDF、扫描件甚至手写记录转换成纯文本。清洗文本时,要统一中英文格式。针对中文军事文本,依靠权威术语集进行精准的分句和分词,然后通过特定模型把一些关键术语给识别并标注出来,最后对来自指挥、情报、演习等多个系统的数据进行融合与归一化处理。
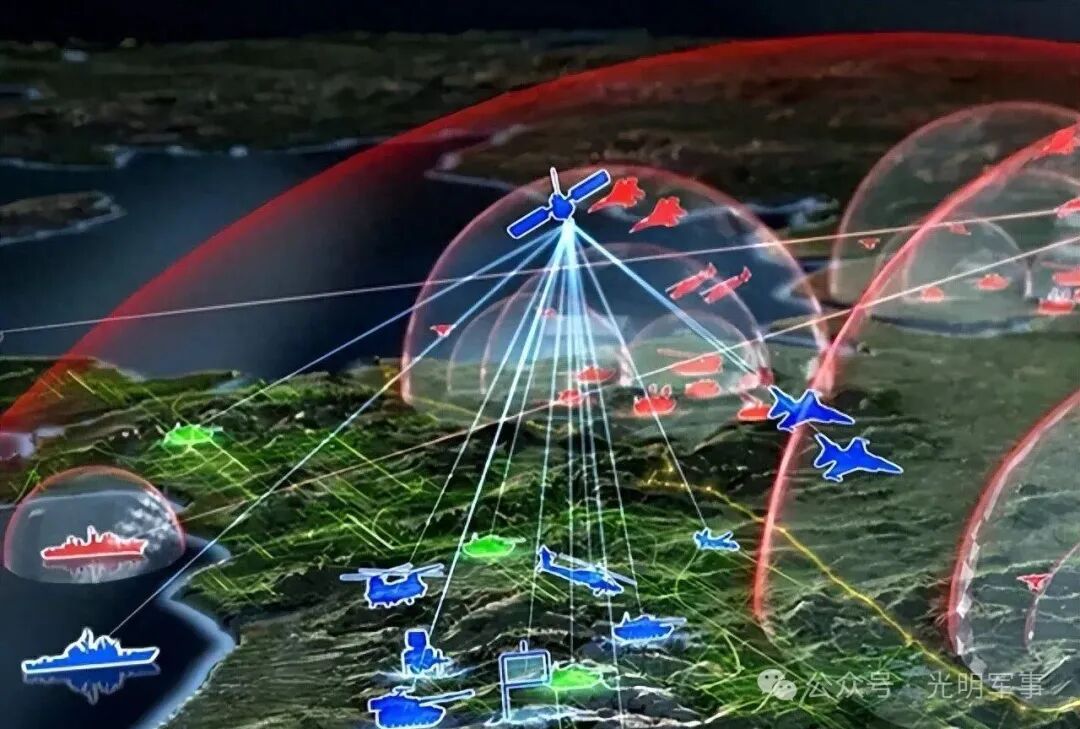
进入核心的智能挖掘环节,多模态信息融合成了重头戏。利用Transformer架构(一种基于自注意力机制的深度学习架构)的全局注意力机制,把文本、卫星图像、雷达轨迹甚至音频数据映射到同一个高维语义空间里。这就像是给模型装上了通感能力,让它不仅能“看图说话”,还能结合文本描述深度理解战场态势。在设计时还特别加入时空感知模块,专门用来捕捉视频里的动作变化和物体位置,构建出一个可解释的认知语义网络。
挖掘出来的知识必须经过规范化处理才能输出。建立一套严格的知识生产和采集标准,把零散的知识点按逻辑梳理成结构化的框架。在这里,本体表示方法发挥了大作用。它就像是给人工智能制定了一套专属的“共享词汇表”,让机器能读懂人类的战术智慧。坚持语义一致、证据可追溯的原则,确保输出的知识不仅机器好用,人看了也觉得明白。流程的最后一环是决策适配。这套系统能直接接入指挥决策闭环,帮指挥员从海量情报中筛出高价值信息,极大缩短了从态势感知到行动决策的响应周期。比如在遇到突发险情时,大模型能综合周边资源和风险等级,瞬间推演出多套作战方案供指挥长参考,并根据事态发展实时更新。
适配军事领域的大模型微调方案设计
要让大模型适配军事领域的应用需求,领域适配是基础。耗费大量精力建设了一个覆盖七十多个场景的大规模军事语料库,把法规条例、武器参数甚至后勤程序都囊括在内。不仅定义了严格的军事术语本体,还把这些规则和预训练模型结合起来,抽取知识三元组存入图数据库。在预训练时,通过特定的输入设计让模型学会区分不同类型的军事文本,同时融入积累的领域实体知识,这让模型在识别精度和处理速度上都有了明显提升。
有了领域知识打底,还得让模型能支持多任务并行处理,这就是任务适配。军事文本挖掘的需求太多样了,既要能从残缺不全的短情报里揪出关键实体,又要能在问答系统中精准匹配战术意图。设计的多任务学习架构和混合抽取方法,让模型既能遵守严谨的军事规则,又能发挥深度学习的泛化能力。在复杂的作战意图识别中,这种层次化的建模方式极大地提高了任务处理的成功率。
绝不能忽视的是安全适配。军事应用对数据的敏感度极高,所以在微调方案中融入一整套智能迭代升级的安全加固服务,从数据加密传输到模型权限分级,全流程审计。为了在边缘设备或者无人平台上部署,采用了参数高效微调技术和知识蒸馏算法,在不牺牲模型认知能力的前提下,大幅降低了算力需求。这种“大模型带小模型”的创新架构,结合强化学习和多智能体协同规划,将在未来的军事智能推演和实战指挥中释放出巨大的能量。
文章来源:光明军事